Importkonfiguration erstellen
Ausführung einer Importkonfiguration
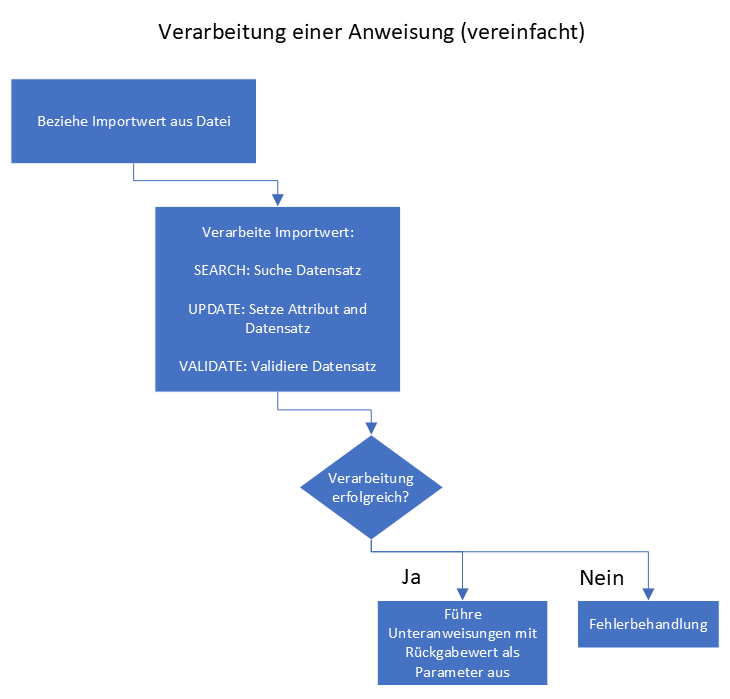
Die Logik, die bei dem Import einer Datei mit einer Importkonfiguration ausgeführt wird, wird über ihre Anweisungen definiert. Jede Anweisung stellt einen einzelnen Schritt des Imports dar, wie etwa das Suchen einer Probe über ihre Kurzbezeichnung oder das Setzen eines Analysedatums an einer Ergebniszuordnung.
Bei einem Import werden der Ordnung nach alle Anweisungen einer Importkonfiguration ausgeführt. In #anweisung_ablauf_vereinfacht ist die Logik für die Verarbeitung einer Anweisung in simplifizierten Schritten dargestellt.
-
Jede Anweisung enthält Bereichs- und Positionsdaten, mit denen die relevanten Zellen in der Importdatei bestimmt werden können, die von der Anweisung verarbeitet werden sollen. Für jeden Importwert wird die Anweisung einmal ausgeführt.
-
Die Funktion einer Anweisung wird durch ihren Typ bestimmt. Anweisungen des Typs SEARCH dienen dazu, Datensätze anhand des importierten Wertes zu finden oder ggf. zu erstellen. Ein häufiger Anwendungsfall für eine SEARCH-Anweisung wäre die Ermittlung einer Probe anhand ihrer Kurzbezeichnung. Alternativ können die zu verarbeitenden Datensätze mit einer Anweisung des Typs USE_SELECTED direkt übergeben werden. Um zu überprüfen, ob gefundene Datensätze valide sind und weiterverarbeitet werden dürfen, kann eine VALIDATE -Anweisung verwendet werden. Mit dem Anweisungstyp UPDATE lassen sich Attribute an gefundenen Datensätzen setzen. Hiermit könnte an einer gefundenen Probe z.B. das Nahmedatum eingetragen werden.
-
War die Ausführung der Logik erfolgreich, so wird das Ergebnis an die Unteranweisungen der Anweisung weitergegeben, welche anschließend nacheinander auf die gleiche Weise ausgeführt werden. Ist jedoch ein Fehler bei der Verarbeitung aufgetreten, werden unabhängig von dem eingestellten Validierungsverhalten die Unteranweisungen übersprungen. Außerdem wird eine vorkonfigurierte Fehlerbehandlung ausgeführt.
Ausgewählte Datensätze in einer Importkonfiguration verwenden
Durch die Verwendung des vordefinierten Makro-Aufufs Importkonfiguration ausführen können Datensätze direkt an die Importkonfiguration übergeben werden. Als Voraussetzung muss in der Importkonfiguration eine Anweisung des Typs USE_SELECTED vorhanden sein, die als Rückgabetyp den gewünschten Datentyp besitzt (z.B. Probe). Weiterhin muss ein Rückgabe-Alias an der Anweisung gepflegt sein. Die Datensätze können anschließend regulär in Nachfolgeanweisungen verwendet werden.
Aufbau einer Anweisung
Nachfolgend wird erklärt, wie die einzelnen Anweisungen einer Konfiguration aufgebaut sind und welche Bedeutung ihre individuellen Felder besitzen.

Verfügbare Felder
-
Anweisung
Die Ordnungszahl der Anweisung. Bestimmt die Reihenfolge, in der die Anweisungen ausgeführt werden.
-
Beschreibung
Die Beschreibung der Anweisung. Wird verwendet, um die Anweisung in den Logs zu identifizieren.
Beispiel: Suche Probe
-
Anweisungstyp
Der Typ der Anweisung bestimmt, was für eine Logik von ihr ausgeführt wird.
- SEARCH: Ein Datensatz wird gesucht und ggf. erstellt
- UPDATE: An einem bestehenden Datensatz wird ein Attribut gesetzt
- VALIDATE: Ein bestehender Datensatz wird validiert
- USE_SELECTED: Von außen an das Import-Tool übergebene Datensätze werden zur weiteren Verarbeitung zurückgegeben.
-
Bereich
Definiert die Bereiche, die jeweils für einen zu bearbeitenden Datensatz relevant sind. Ein Bereich kann z.B. definieren, dass zeilenweise durch bestimmte Spalten einer Datei durchiteriert wird. So würde die Anweisung für jede Zeile einmal ausgeführt werden.
Beispiel: From(Row(3)).repeat(1)
-
Position
Definiert die konkrete Zelle im definierten Bereich, in der sich der zu importierende Wert für die Anweisung befindet. Dies kann zum Beispiel in der aktuellen Zeile der momentanen Bereichsiteration der Wert in der zweiten Spalte sein.
Beispiel: currentRow.Col(2)
-
Rückgabetyp
Nur relevant (und editierbar) für SEARCH-Anweisungen. Definiert die Klasse des zu suchenden Datensatzes. Sollte kein Skript gesetzt sein, und daher die interne Logik für die Anweisung verwendet werden, wird diese Angabe benutzt, um den richtigen Programm-Aufruf für das Suchen und Erstellen des Datensatzes zu generieren.
Wird weiterhin für das Logging verwendet.
Beispiele: Probe,ZuordnungProbeAnalyseErgebnis
-
Rückgabe-Alias
Der Rückgabewert der Anweisung wird als Variable in den Skripten der Unteranweisungen und Nachfolgeanweisungen verfügbar sein. Der Rückgabe-Alias bestimmt den Namen, den diese Variable hat.
-
Spaltenname
Der Name des Attributs, für das der Importwert verwendet wird. Bei SEARCH -Anweisungen werden gefundene Datensätze danach gefiltert, ob dieses Attribut gleich dem Importwert ist. Beispielsweise wäre bei einer SEARCH-Anweisung, die eine Probe anhand ihrer Kurzbezeichnung suchen soll, der Spaltenname kurzbezeichnung.
Bei UPDATE -Anweisungen bestimmt der Spaltenname, an welches Attribut der Importwert gesetzt werden soll. Eine UPDATE-Anweisung, die das Nahmedatum einer Probe setzen soll, würde hier nahmedatum verwenden. Auch bei Anweisungen, die ein Skript verwenden und demnach keine Spaltenangabe benötigen, sollte dieses Feld gesetzt sein, da es bei dem Logging verwendet wird, um den Verarbeitungsablauf der Anweisung zu dokumentieren.
-
Konverter
Ein Groovy-Skript, das den aus der Importdatei bezogenen Wert in ein passendes Format konvertiert, bevor er weiterverarbeitet wird. Dies kann zum Beispiel für das Konvertieren von einem Datumsstring zu einem Date-Objekt verwendet werden. Dem Skript stehen alle Variablen zur Verfügung, die der Anweisung aus vorherigen Anweisungen übergeben wurden. Der importierte Wert ist über die Variable "value" verfügbar und kann ein String-, Double- oder Boolean-Wert sein. Der konvertierte Wert muss in einem Return-Statement zurückgegeben werden und kann einen beliebigen Typ haben.
Beispiel:
//value = Importwertreturn (new java.text.SimpleDateFormat( "MM/dd/yyyyHH:ss")).parse(value); -
Skript
Anmerkung: Das Skript-Feld hat immer die folgenden Variablen zur Verfügung:
st- eine SaveTransaction-Instanzlogger- Eine Logger-Instanz Ist dieses Groovy-Skript gesetzt, wird nach der Konvertierung des Importwertes lediglich dieses Skript zur Verarbeitung verwendet. Es erfolgt keine interne Logik. Der importierte Wert ist über die Variable "value" verfügbar und kann ein String-, Double- oder Boolean-Wert sein. Dem Skript stehen alle Variablen zur Verfügung, die der Anweisung aus vorherigen Anweisungen übergeben wurden. Der erwartete Rückgabewert ist von dem Anweisungstyp abhängig:
- SEARCH: Der gefundene/erstelle Datensatz, sonst null
- UPDATE: Wenn erfolgreich: null, sonst ein String mit einer Fehlermeldung
- VALIDATE: Wenn erfolgreich: null, sonst ein String mit einer Fehlermeldung
-
Suchverhalten
Nur relevant (und editierbar) für SEARCH -Anweisungen ohne gesetztes Skript-Feld. Dieses Drop-Down-Feld definiert das Verhalten, wenn die Anweisung keinen Datensatz mit dem gesuchten Attribut finden konnte.
- CREATE: Es wird versucht, über die interne Logik einen neuen Datensatz zu erstellen und das gesuchte Attribut auf den importierten Wert zu setzen. Damit dies funktioniert, muss der Rückgabetyp und der Spaltenname gesetzt sein.
- ERROR: Es wird eine Fehlermeldung geloggt. Die Anweisung ist fehlgeschlagen.
- IGNORE: Dieser Durchlauf der Anweisung wird ignoriert. Die Verarbeitung wird fortgesetzt.
-
Aktualisierungsverhalten
Nur relevant (und editierbar) für UPDATE -Anweisungen ohne gesetztes Skript-Feld. Dieses Drop-Down-Feld definiert das Verhalten, wenn das zu ändernde Attribut an dem übergebenen Datensatz bereits einen Wert enthält.
- OVERWRITE: Der Wert wird überschrieben
- DONT_OVERWRITE: Der Wert bleibt unverändert
-
Validierungsverhalten
Dieses Drop-Down-Feld definiert das Verhalten, wenn bei der Verarbeitung der Anweisung oder ihrer Unteranweisungen ein Fehler aufgetreten ist. Der hier eingestellte Wert hat lediglich einen Einfluss darauf, ob Folgebereiche und Folgeanweisungen der gleichen Ebene ausgeführt werden. Unteranweisungen werden immer übersprungen, wenn die Hauptlogik einer Anweisung nicht erfolgreich war.
- WARN: Es wird lediglich eine Warnung geloggt. Der Prozess wird nicht abgebrochen.
- SKIP_BEREICH: Der aktuelle (Oberanweisungs-)Bereich wird übersprungen.
- SKIP_ANWEISUNG: Die Verarbeitung der Anweisung wird abgebrochen und es wird zur nächsten Anweisung gesprungen.
- ABORT: Der Import wird abgebrochen. Alle bisherigen Änderungen werden rückgängig gemacht.
Definition von Bereichen und Positionen für Import-Anweisungen
Fachlicher Hintergrund
Mit den Import-Anweisungen können Informationen aus einer tabellarisch aufgebauten Importdatei extrahiert und in die Datenstrukturen des diaLIMS überführt werden. Hierzu müssen Bereiche und Positionen definiert werden können, aus denen die zu überführenden Informationen extrahiert werden.
Das Bereichsskript definiert pro Datensatz einen definierten Tabellenbereich, anhand dessen die Positionen ermittelt werden können. Der Bereich kann absolut, Oberanweisung-abhängig und wiederholend angegeben werden. Abhängige Definitionen beziehen sich immer auf den Bereich der Oberanweisung. Wird kein Bereich angegeben, gilt der Bereich der Oberanweisung komplett. Ist keine Oberanweisung vorhanden, wird sich auf den gesamten Bereich der Importdatei bezogen. Nur Bereichsdefinitionen oder gar keine Angabe sind gültig.
Das Positionenskript definiert pro Datensatz eine oder mehrere Zellen, aus denen die Informationen extrahiert werden. Die Positionen können als absolut, bereichsabhängig oder wiederholend angegeben werden. Abhängige Positionen beziehen sich immer auf den Bereich derselben Anweisung. Es wird immer eine Position erwartet, da sonst keine Informationen extrahiert werden können. Nur Zellendefinitionen sind gültig.
Im Folgenden gibt es eine Übersicht der Anweisungen, um eine Bereichs- bzw. Positionendefinition zu erstellen:
Angabe von Spalten bzw. Zeilen
Col(index)
Definiert eine eindeutige Spalte an dem Index.
//Die dritte Spalte der Datei
Col(3)
Col_Bereich(index)
Definiert eine bereichsabhängige Spalte. Der Index wird entsprechend der Bereichsdefinition aufgelöst.
//Die dritte Spalte des Oberbereiches
Col_Bereich(3)
currentCol
Definiert einen Zähler für Spalten. Dabei wird jede Spalte des Bereichs wiederholt.
//Die zweite Zeile der aktuellen Iterationsspalte
currentCol.Row(2)
findColWithDifferentContentThan(Cell)
Definiert eine Spalte, die anhand eines Vergleichswerts ermittelt wird. Der Vergleichswert wird über die Zelle angegeben. Die Spalte wird gesucht, indem die Werte in derselben Zeile wie die angegebene Zelle verglichen werden. Es wird die Spalte ermittelt, deren Wert sich von dem des Vergleichswerts unterscheidet.
//Findet die nächste Spalte, die einen anderen Wert als "Ergebnis-ID 1" in der gleichen Zeile wie die übergebene Zelle hat
findColWithDifferentContentThan(Cell("Ergebnis-ID 1"))
Row(index)
Definiert eine eindeutige Zeile an dem Index.
//Die absolute dritte Zeile in der Datei
Row(3)
Row_Bereich(index)
Definiert eine bereichsabhängige Zeile. Der Index wird entsprechend der Bereichs-Definition aufgelöst.
//Die dritte Zeile des Oberbereiches
Row_Bereich(3)
currentRow
Definiert einen Zähler für Zeilen. Dabei wird jede Zeile des Bereichs wiederholt.
currentRow.Col(5)
findRowWithDifferentContentThan(Cell)
Definiert eine Zeile, die anhand eines Vergleichswerts ermittelt wird. Der Vergleichswert wird über die Zelle angegeben. Die Zeile wird gesucht, indem die Werte in derselben Spalte wie die angegebene Zelle verglichen werden. Es wird die Zeile ermittelt, deren Wert sich von dem des Vergleichswerts unterscheidet.
//Findet die nächste Zeile, die einen anderen Wert als "Ergebnis-ID 1" in der gleichen Spalte wie die übergebene Zelle hat
findRowWithDifferentContentThan(Cell("Ergebnis-ID 1"))
findColThatMatches(suchbegriff) / findColThatMatches(suchbegriff,rowIndex)
Findet die nächste Spalte, die eine Zelle enthält, deren Inhalt zu dem übergebenen Regex-String passt. Optional kann der Suchbereich eingegrenzt werden, indem man einen Zeilenindex übergibt.
//Findet die erste Spalte, die eine Zelle enthält,
// deren Inhalt mit "S" beginnt und mit "2" aufhört
findColThatMatches(\"S.+2\")

//Findet die erste Spalte, die eine Zelle in Zeile 5 enthält,
//deren Inhalt mit "S" beginnt und mit "2" aufhört
findColThatMatches(\"S.+2\",5)
findRowThatMatches(suchbegriff) / findRowThatMatches(suchbegriff,colIndex)
Findet die nächste Zeile, die eine Zelle enthält, deren Inhalt zu dem übergebenen Regex-String passt. Optional kann der Suchbereich eingegrenzt werden, indem man einen Spaltenindex übergibt.
//Findet die erste Zeile mit einer Zelle, deren Inhalt mit "S" beginnt und mit "1" aufhört
findRowThatMatches(\"S.+1\")

//Findet die erste Zeile mit einer Zelle in Spalte 4,
//deren Inhalt mit "S" beginnt und mit "1" aufhört
findRowThatMatches(\"S.+1\",4)
findColWithEmptyCell(rowIndex)
Findet die nächste Spalte, die eine Zelle enthält, deren Inhalt leer ist. Optional kann der Suchbereich eingegrenzt werden, indem man einen Zeilenindex übergibt.
//Findet die erste Spalte mit einer leeren Zelle in Zeile 3.
findColWithEmptyCell(3)
findRowWithEmptyCell(colIndex)
Findet die nächste Zeile, die eine leere Zelle enthält. Optional kann der Suchbereich eingegrenzt werden, indem man einen Spaltenindex übergibt.
//Findet die erste Zeile mit einer leeren Zelle in Spalte 6
findRowWithEmptyCell(6)
Angabe von Zellen
Cell(colIndex, rowIndex)
Definiert eine Zelle mit einer eindeutigen Spalte und Zeile für die jeweiligen Indizes (colIndex für Spalte, rowIndex für Zeile).
//Definiert die Zelle in der Spalte 5 und Zeile 4
Cell(5,4)
Cell_Bereich(colIndex, rowIndex)
Definiert eine Zelle mit einer bereichsabhängigen Spalte und Zeile für die jeweiligen Indizes (colIndex für Spalte, rowIndex für Zeile). Die Indizes werden entsprechend der Bereichsdefinition aufgelöst.
//Definiert die Zelle in der fünften Spalte und vierten Zeile des Bereiches
Cell_Bereich(5,4)
Cell(suchbegriff)
Definiert eine Zelle, deren Index über einen Suchbegriff gesteuert wird. Der Suchbegriff muss 1:1 in der Zelle angegeben sein. Optional kann ein zusätzlicher Schalter "ignoreCase" übergeben werden, um zu definieren, ob bei der Suche die Groß- und Kleinschreibung beachtet werden soll.
//Definiert die erste Zelle in der Datei, die den String "Ergebnis-ID 1" enthält
Cell("Ergebnis-ID 1")

//Sucht schreibungsunabhängig nach dem Suchbegriff
Cell("ergebnis-id 1",true)
findCellThatMatches(suchbegriff)
Definiert eine Zelle, deren Index über ein Regex-Pattern gesteuert wird. Es wird nach einer Zelle gesucht, deren Inhalt zu dem Regex-Suchmuster passt.
//Definiert die erste Zelle, deren Inhalt mit "S" beginnt und mit "1" aufhört
findCellThatMatches(\"S.*1\")
findCellThatContains(suchbegriff,ignoreCase)
Es wird nach einer Zelle gesucht, die den Suchbegriff enthält. Es kann definiert werden, ob die Groß- und Kleinschreibung beachtet werden soll. Der zweite Parameter ist optional.
//Definiert die erste Zelle, die "B1" enthält. Das "B" muss groß geschrieben sein.
findCellThatContains(\"B1\",true)
Col.Row
Beliebige Spalten- und Zeilen-Definitionen können verbunden werden, um eine Zelle abzubilden. Dabei gelten die jeweiligen Spalten- bzw. Zeilen-Definitionen für die Zelle.
//Gibt die Zeile der ersten Zelle zurück, die den Inhalt "Ergebnis-ID 1" besitzt
Cell("Ergebnis-ID 1").Row()
Angabe von Bereichen
Bereichsdefinition leer lassen
Definiert einen Bereich abhängig von der übergeordneten Anweisung. Tendenziell wird der Bereich der übergeordneten Anweisung oder, wenn keine vorhanden, die gesamte Importdatei verwendet. (Analog zu 'bereich()') Gibt es eine übergeordnete Anweisung mit einer iterierenden Position (in dem Positionsdefinition wird 'currentRow' oder 'currentCol' verwendet), wird der Bereich in derselben Richtung iteriert. (Analog zu 'From(Row_Bereich(1)).repeat(1)' in Zeilen- und 'From(Col_Bereich(1)).repeat(1)' in Spaltenrichtung) Andernfalls findet keine Iteration statt und der Bereich wird als Ganzes verwendet.
From(Col/Row)
Definiert den Start eines Bereichs unter Angabe einer Spalte oder Zeile. Die Spalte bzw. Zeile wird in den Bereich mit einbezogen.
Tipp:
Wird lediglich ein From definiert, wird das Ende durch die importierte Datei selbst bestimmt.
//Definiert einen Bereich, der bei Spalte 3 der Datei beginnt und bei der Spalte 10 endet
From(Col(3)).to(Col(10))
After(Col/Row)
Definiert den Start eines Bereichs unter Angabe einer Spalte oder Zeile. Die Spalte bzw. Zeile wird nicht in den Bereich mit einbezogen, der Bereich startet nach der Spalte bzw. Zeile.
Tipp:
Wird lediglich ein After definiert, wird das Ende durch die importierte Datei selbst bestimmt.
//Definiert einen Bereich, der bei Spalte 4 der Datei beginnt und bei der Spalte 10 endet
After(Col(3)).to(Col(10))
bereich()
Es wird der Start des Bereichs der Oberanweisung für die Definition verwendet.
//Beginnt eine Iteration durch jede Zeile des Oberbereiches
bereich().repeat(1)
Start.to(Col/Row)
Definiert das Ende eines Bereichs unter Angabe einer Spalte oder Zeile. Die Spalte bzw. Zeile wird in den Bereich mit einbezogen. Zusammen mit der Start-Definition wird ein Bereich definiert.
//Definiert einen Bereich, der bei Spalte 3 der Datei beginnt
// und bei der Spalte 10 endet
From(Col(3)).to(Col(10))
Start.toTheEnd()
Definiert das Ende eines Bereichs mit dem Ende der importierten Datei.
//Definiert einen Bereich, der in Zeile 3 der Datei beginnt
//und bis zu dem Ende der Datei geht
From(Row(3)).toTheEnd()
Start.until(Col/Row)
Definiert das Ende eines Bereichs unter Angabe einer Spalte oder Zeile. Die Spalte bzw. Zeile wird nicht in den Bereich mit einbezogen, der Bereich endet vor der Spalte bzw. Zeile. Zusammen mit der Start-Definition wird ein Bereich definiert.
//Definiert einen Bereich, der in Spalte 3 beginnt und in Spalte 9 endet.
From(Col(3)).until(Col(10))
Start.repeat(anzahl)
Definiert ein dynamisches Ende des Bereichs, sodass mehrere Bereiche mit der Anzahl an Spalten bzw. Zeilen wiederholt werden. Die Start-Definition bestimmt hierbei, ob die Wiederholung spalten- oder zeilenweise erfolgt. Der nächste Bereich startet eine Spalte bzw. Zeile, nachdem der letzte Bereich endet.
//Ab Zeile 3 wird die Datei in Bereiche von je drei Zeilen aufgeteilt und durchlaufen
From(Row(3)).repeat(3)
Start.repeatUntil(Col/Row)
Definiert ein dynamisches Ende des Bereichs, sodass mehrere Bereiche wiederholt werden. Ein Bereich endet, sobald die übergebene Spalte bzw. Zeile erreicht wird. Diese ist nicht mehr Teil des aktuellen Bereichs. Die Start-Definition bestimmt hierbei, ob die Wiederholung spalten- oder zeilenweise erfolgt. Der nächste Bereich startet eine Spalte bzw. Zeile, nachdem der letzte Bereich endet.
// Definiert einen Bereich, der in Zeile 3 der Datei beginnt
// und mit Zeile 10 endet.
//Ab Zeile 11 wird ein neuer Bereich begonnen.
From(Row(3)).repeatUntil(Row(10))
Verarbeitung einer Importkonfiguration
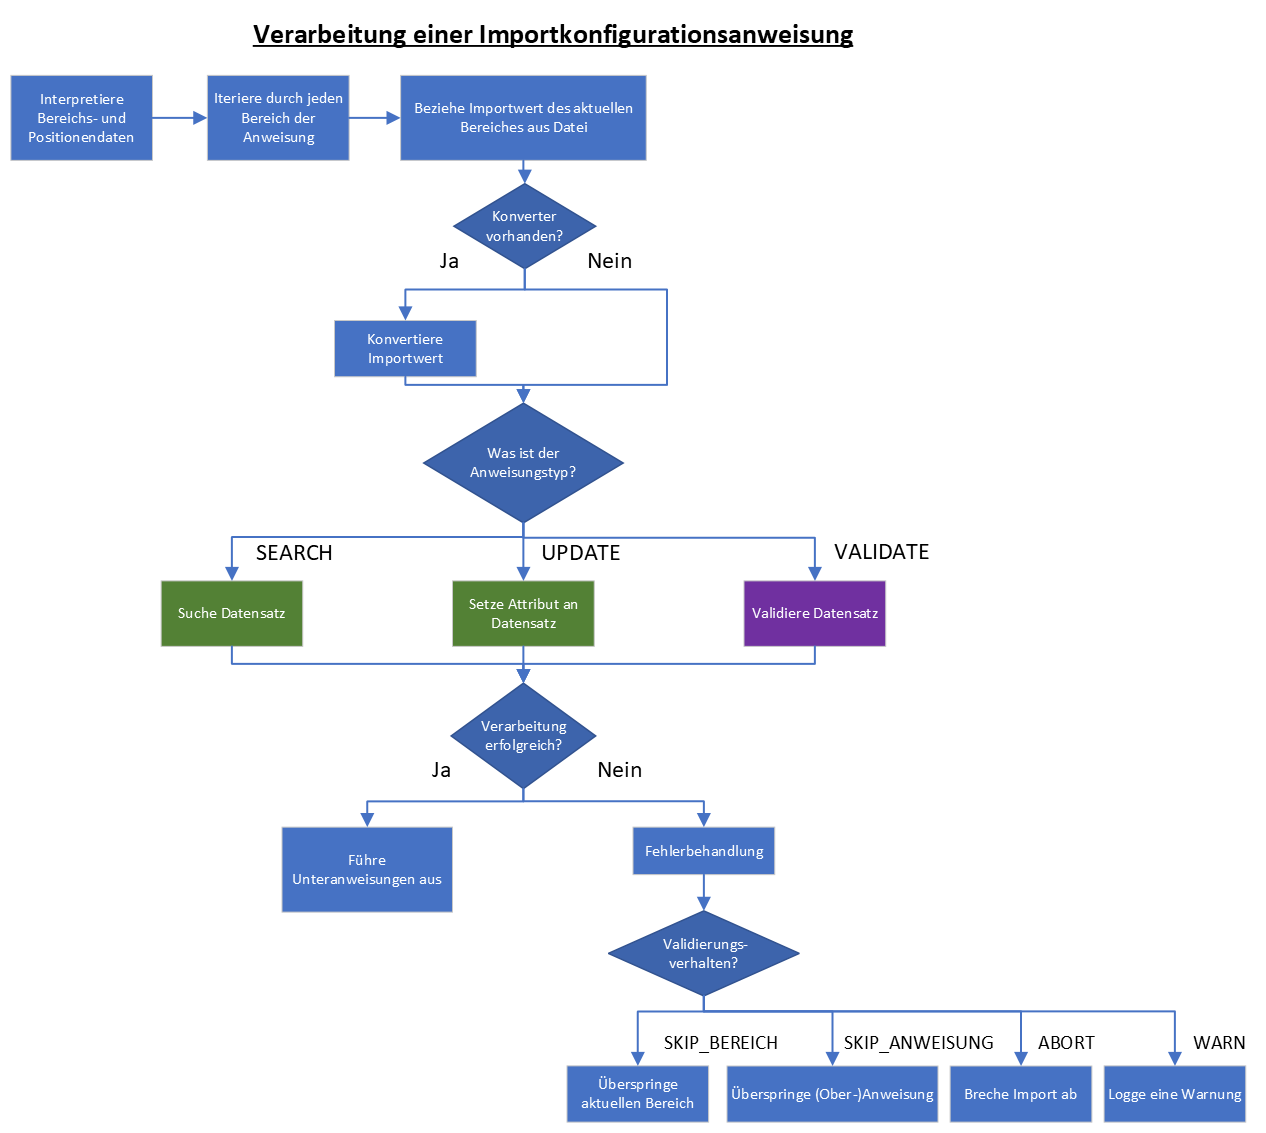
Im vorherigen Abschnitt wurden im Detail die einzelnen Konfigurationsmöglichkeiten an einer Importkonfiguration und ihren Anweisungen erklärt. In Abbildung 3 wird illustriert, wie sich diese konkret in den Verarbeitungsablauf einer Anweisung einfügen.
Ermittlung des Importwertes
Anhand der Bereichs- und Positionendaten werden die Zellen in der Importdatei ermittelt, die von der Anweisung verarbeitet werden sollen und importiert. Für jeden Wert wird die Anweisung einmal ausgeführt.
Ist ein Konverter-Skript gesetzt, wird der Importwert anhand des Skriptes in ein passendes Format überführt, bevor er weiterverarbeitet wird.
Typabhängige Verarbeitung
Wurde ein Importwert ermittelt, folgt die Ausführung der Kernlogik der Anweisung. Diese ist abhängig von ihrem Typ.
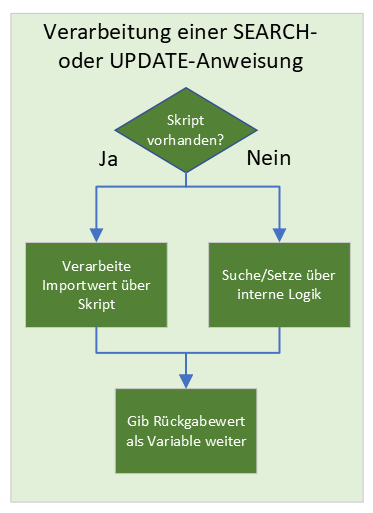
Handelt es sich bei der Anweisung um eine SEARCH- oder UPDATE-Anweisung, erfolgt die Verarbeitung wie in Abbildung 4 dargestellt. Ist kein Skript vorhanden, so wird anhand des gesetzten Rückgabe-Typs und Spaltennamens selbständig eine Abarbeitung des Wertes erfolgen.
Im Falle einer SEARCH-Anweisung bedeutet dies, dass der Rückgabe-Typ verwendet wird, um den Importwert auf den korrekten Typ zu prüfen und ggf. zu konvertieren (nur bei String-Attributen) und den korrekten Controller für den Businesstyp des Wertes zu ermitteln. Anschließend erfolgt eine Suche, bei der nach Datensätzen gefiltert wird, bei denen in der Spalte (dem Feld) der gesuchte Wert gesetzt ist. Ist die Suche erfolglos, wird eine Alternativlogik ausgeführt, die abhängig von dem gesetzten Suchverhalten ist. Es wird entweder ein neuer Datensatz mit dem korrekten Attribut erstellt, eine Fehlermeldung ausgegeben oder nichts getan.
Ist der Typ der Anweisung UPDATE, erfolgt zunächst eine ähnliche Logik wie bei SEARCH-Anweisungen. Der Importwert wird darauf geprüft, ob er an der angegebenen Spalte gesetzt werden kann und ggf. konvertiert. Anschließend wird er an dem Datensatz gesetzt. Wird festgestellt, dass das betroffene Feld bereits einen Wert besitzt, wird dieser abhängig von dem gesetzten Aktualisierungsverhalten überschrieben oder nicht.
Ist ein Skript vorhanden, wird der Importwert stattdessen darüber verarbeitet und zurückgegeben. Eventuell notwendige Überprüfungen und Konvertierungen müssen ebenfalls in dem Skript erfolgen.
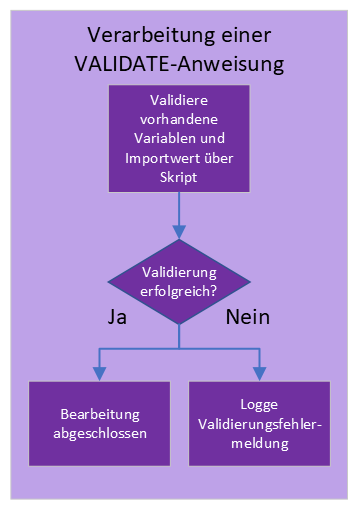
Bei VALIDATE-Anweisungen gibt es keine interne Logik, weshalb ein Verarbeitungsskript zwingend vorhanden sein muss. In dem Skript kann ein Importwert oder bestehende Datensätze validiert werden. Der abweichende Verlauf der Bearbeitung ist in Abbildung 5 illustriert. Ist die Validierung erfolgreich, so können die Unteranweisungen ausgeführt werden. Bei einer fehlgeschlagenen Validierung, wird im Skript eine Zeichenkette mit dem Grund des Fehlers zurückgegeben. Dieser wird als Teil des Log-Eintrags ausgegeben, der am Ende des Imports erstellt wird und danach und in dem Tab Log-Einträge zur Verfügung steht.
Ausführung von Unteranweisungen
War die Verarbeitung erfolgreich, werden die Unteranweisungen ausgeführt. Diese erhalten die Rückgabewerte ihrer Oberanweisung in Form von Skript-Parametern, die den an der Anweisung gesetzten Rückgabe-Alias als Namen tragen. Bei mehreren Rückgabewerten erfolgt je eine Iteration der Unteranweisungen pro Wert. Der Erfolg der Anweisung als Ganzes ist davon abhängig, ob auch in ihren Unteranweisungen keine Fehler auftreten.
Fehlerbehandlung
Ist bei der Verarbeitung der Anweisung oder ihrer Unteranweisungen ein Fehler aufgetreten, so wird eine vordefinierte Fehlerbehandlung durchgeführt. Abhängig von dem eingestellten Validierungsverhalten der Anweisung geschieht Folgendes:
- WARN: Es wird eine Warnung geloggt. Die Anweisung selbst gilt daraufhin als erfolgreich ausgeführt. Die nächste Iteration/Anweisung wird bearbeitet.
- ABORT: Der Import wird abgebrochen und bisherige Änderungen rückgängig gemacht.
- SKIP_BEREICH: Der aktuelle Bereich wird übersprungen. Es wird mit dem nächsten Bereich fortgefahren.
- SKIP_ANWEISUNG: Die komplette Anweisung wird übersprungen. Die nächste Anweisung wird bearbeitet.
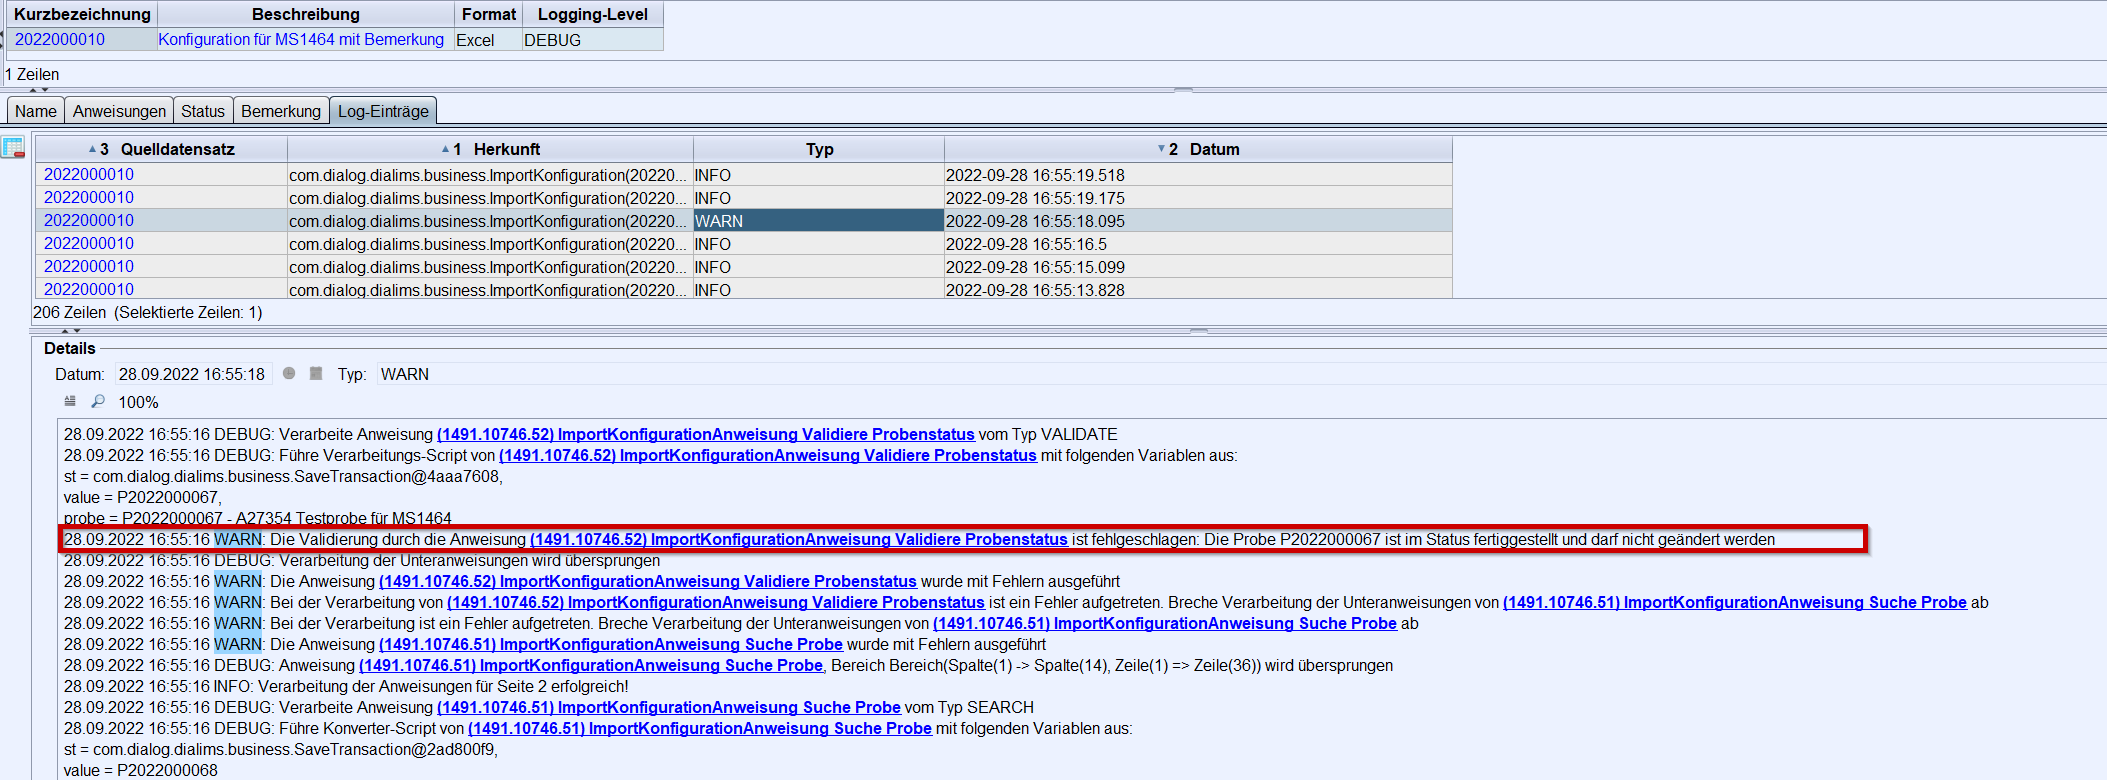
Geloggte Fehlermeldungen erscheinen im Log-Eintrag des Importvorgangs wie in Abbildung 6 zu sehen. Der abgebildete Log-Eintrag enthält eine Warnung, die aussagt, dass die Validierung einer gefundenen Probe fehlgeschlagen ist, da diese storniert ist. Die Log-Ausgaben sind abhängig von dem an der Importkonfiguration eingestelltem Log-Level. Es werden lediglich Ausgaben geloggt, deren Stufe dem Log-Level entspricht oder höher ist. Die abgebildete Konfiguration besitzt das Log-Level DEBUG, weshalb die Log-Einträge alle Logausgaben enthalten.
Aufbau einer validen Importkonfiguration
Angabe von validen Excel-Seiten
Bei dem Import von Excel-Dateien muss beachtet werden, dass die im Feld Excel-Seiten konfigurierten Seiten tatsächlich an allen zu importierenden Dateien vorhanden sind. Wird während eines Imports festgestellt, dass eine gesuchte Seite nicht in der Importdatei existiert, so wird der Import abgebrochen.
Anordnung von Anweisungen
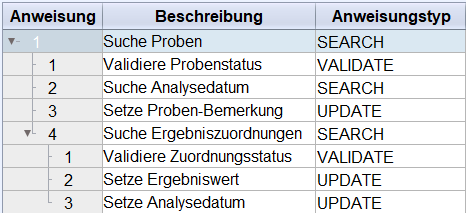
Es gibt drei Anweisungstypen (SEARCH, UPDATE, VALIDATE). Von diesen Anweisungstypen setzen VALIDATE- und UPDATE-Anweisungen bereits verfügbare Datensätze zur Bearbeitung voraus, da sie diese manipulieren oder überpüfen müssen. Folglich muss die erste Anweisung jeder Importkonfiguration eine SEARCH -Anweisung sein. Damit UPDATE- und VALIDATE-Anweisungen Zugriff auf die relevanten Datensätze erhalten können, müssen sie Unteranweisungen oder Folgeanweisungen der SEARCH-Anweisung sein, die diesen Datensatz ermittelt. Dies ist in Abbildung 7 oben zu sehen: Die SEARCH-Anweisung zur Ermittlung einer Probe ist die Anweisung an erster Stelle und auf höchster Ebene, da alle anderen Anweisungen die gefundene Probe weiterverarbeiten. Es gibt eine weitere Verschachtelung bei der SEARCH-Anweisung für die Ergebniszuordnungen der Probe, da ihre Unteranweisungen jeweils einmal für jede gefundene Zuordnung ausgeführt werden sollen.
Die Bereichsdefinitionen von Unteranweisungen müssen Unterbereiche des Bereichs der Oberanweisung darstellen. (Dies lässt sich über die  Bereichs- und Positionendaten-Funktion auf der Anweisungen-Seite testen).
Bei dem Aufbau einer Konfiguration muss beachtet werden, dass die Rückgabewerte von Anweisungen nur in deren Unteranweisungen und nachfolgenden Unteranweisungen verfügbar sind. Anweisungen auf höchster Ebene haben keinen Zugriff auf ihre jeweiligen Rückgabewerte. Möchte man zum Beispiel mehrere Messungen zu einer Ergebniszuordnung hinzufügen, so muss die UPDATE-Anweisung für das Setzen des Wertes eine Unteranweisung der SEARCH-Anweisung für die Ergebniszuordnung sein.
Definition valider Bereiche und Positionen
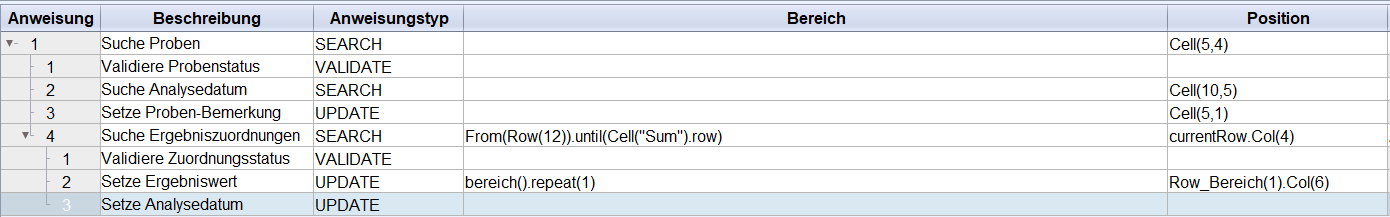
Bereiche sind streng hierarchisch aufgebaut, d.h. Bereiche von Unteranweisungen müssen Teilbereiche des Bereiches der Oberanweisung sein (dies gilt jedoch nicht für Positionsangaben). Alternativ kann eine Anweisung einen Teilbereich dadurch implizieren, dass kein Bereich gesetzt ist, wodurch stattdessen der Oberbereich verwendet wird.
Positionen wiederum müssen die konkreten Zellen definieren, die durch die Anweisung bearbeitet werden sollen.
Ist weder ein Bereich noch eine Position gesetzt, kann eine Anweisung lediglich die im Script verfügbaren Variablen verarbeiten und erhält keinen eigenen Importwert.
Im oberen Beispiel sind verschiedene Bereichsdefinitionen zu sehen.
Anweisungen 1 - 1.3 : Die erste Bereichsdefinition erfolgt erst in Anweisung 1.4, was bedeutet, dass der verfügbare Bereich in den Anweisungen davor die ganze Importdatei umfasst.
Die Positionen der Anweisung 1 und ihrer Unteranweisungen 1.2 und 1.3 bestehen aus konkreten Zellen mit absoluten Koordinaten. Die Validierungsanweisung 1.1 hingegen benötigt weder Bereichs- noch Positionsdefinitionen, da sie die Probe validiert, die bereits in der Anweisung 1 ermittelt und weitergegeben wird.
Anweisung 1.4 : Anweisung 1.4 schränkt den Bereich für ihre Unteranweisungen auf die Zeilen ab Zeile 12 und bis zu der Summenzeile (markiert durch eine Zelle, die den Text "Sum" enthält) ein. Die zugehörige Positionsangabe iteriert durch alle Zeilen des Unterbereiches und liefert den Wert in der vierten Spalte. Für jede ermittelte Zelle wird einmal durch die Unteranweisungen iteriert.
Anweisung 1.4.2 : Der Bereich der Anweisung 1.4 wird dann in ihrer Unteranweisung 1.4.2 erneut auf ihre einzelnen Zeilen aufgeteilt. Durch die zugehörige Positionsdefinition wird aus jeder Zeile der Wert aus der sechsten Spalte bezogen.