Ermittlung der passenden Korrekturfaktoren
Reihenfolge zur Ermittlung eines passenden Korrekturfaktors
Es ist tendenziell möglich, dass zwei oder mehr Korrekturfaktoren auf eine Probe zutreffen. Es wird jedoch nur der verwendet, der am besten zutrifft. Dabei sind folgende Abhängigkeiten zu beachten:
Reihenfolge für Korrekturfaktoren vom Typ "Korrekturfaktor"
-
Passender Wertebereich der Korrekturfaktoren
Beispiel: Ein Korrekturfaktor hat dasselbe Produkt wie die Probe, ein anderer Korrekturfaktor hat kein Produkt gesetzt und ist somit eigentlich weniger gewichtet. Der Korrekturfaktor mit Produkt hat einen Wertebereich von 0 bis 2 und der Korrekturfaktor ohne Produkt einen Wertebereich von 2 bis 5. Bei einem Eingabewert von 3 wird hier der Korrekturfaktor ohne Produkt verwendet, weil in dessen Bereich der Eingabewert an der Probe liegt, obwohl der Korrekturfaktor mit Probe von den Stammdatenreferenzen her besser passt.
-
Ein spezifizierter Wert ist gewichtiger als ein nicht spezifizierter Wert
Beispiel: Ein Korrekturfaktor ohne eingetragenes Produkt wird nicht angewendet, wenn es einen (vom Wertebereich her passenden) Korrekturfaktor mit einem gesetztem Produkt gibt und dieses an der Probe gesetzt wurde.
-
Produkt > Produktgruppe > Ansprechpartner > Kunde
Beispiel: Ein Korrekturfaktor für ein Produkt wird einem für einen Ansprechpartner bevorzugt.
Diese Rangfolge kann kundenindividuell über Optionen geändert werden (s. KorrekturfaktorPriority).
-
Engster Wertebereich der Korrekturfaktoren
Beispiel: Zwei Korrekturfaktoren haben dasselbe Produkt gesetzt aber einen Wertebereich von 0 bis 5 bzw. 1 bis 3. Es wird der Korrekturfaktor angewendet, mit dem engsten Bereich, in dem der Eingabewert an der Probe liegt. Bei Eingabewert 1 oder 2 wird also der zweite Korrekturfaktor angewendet. Bei den Eingabewerten 0, 3 oder 4 wird der erste Korrekturfaktor angewendet.
Anmerkung:
Bitte beachten Sie, dass es keine Überschneidungen im Gültigkeitsbereich der definierten Faktorensätze gibt. diaLIMS greift im Zweifelsfall auf den ersten zutreffenden Faktorensatz zu. Dies ist noch aufmerksamer zu kontrollieren, wenn Faktorensätze unterschiedlicher Gültigkeitsbereiche in Abhängigkeit zu anderen Stammdaten angelegt sind.
Beispiel: Bei zwei Korrekturfaktoren mit den Wertebereichen 0 bis 5 und 3 bis 7 kann bei Eingabewert 4 nicht entschieden werden, welches der passende Korrekturfaktor ist. Es wird ein beliebiger der beiden verwendet.
Reihenfolge für Korrekturfaktoren vom Typ "Nachweisgrenze" oder "Bestimmungsgrenze"
-
Ein spezifizierter Wert ist gewichtiger als ein nicht spezifizierter Wert
Beispiel: Eine Nachweis- bzw. Bestimmungsgrenze ohne eingetragenes Produkt wird nicht angewendet, wenn es eine Nachweis- bzw. Bestimmungsgrenze mit einem gesetztem Produkt gibt und dieses an der Probe gesetzt wurde.
-
Produkt > Produktgruppe > Ansprechpartner > Kunde
Beispiel: Eine Nachweis- bzw. Bestimmungsgrenze für ein Produkt wird immer einem für einen Ansprechpartner bevorzugt.
Diese Rangfolge kann kundenindividuell über Optionen geändert werden (s. KorrekturfaktorPriority).
-
Höchster Bis-Wert
Beispiel: Zwei Korrekturfaktoren haben dasselbe Produkt gesetzt aber einen Bis-Wert von 5 bzw. 8. Es wird der Korrekturfaktor angewendet, mit dem höheren Bis-Wert.
Hinweis: Es ist nicht möglich, an einem Ergebnis zwei Nachweisgrenzen oder zwei Bestimmungsgrenzen anzulegen, deren Stammdatenreferenzen gleich sind. Somit kann dieser Punkt nur eintreten, wenn invalide Altdaten vorhanden sind. Solche Daten sollten korrigiert werden.
-
Passender Wertebereich der Korrekturfaktoren
Beispiel: Ist ein eindeutig passender Korrekturfaktor vorhanden, so wird er nur angewendet, wenn der zu korrigierende Wert auch im Wertebereich des Korrekturfaktors liegt.
Ist eine passende Bestimmungsgrenze vorhanden, so wird der Bis-Wert am Probenergebnis im Feld "Bestimmungsgrenze" vermerkt (ggf. korrigiert durch den BG-Faktor), auch wenn der Wert des Ergebnisses nicht unter der Bestimmungsgrenze liegt.
Kombination Korrekturfaktor/Nachweisgrenze/Bestimmungsgrenze
Beim Anwenden von Korrekturfaktoren werden bis zu zwei Korrekturfaktoren pro Eingabewert angewendet.
- Auf den ursprünglichen Wert wird zuerst der passende Korrekturfaktor vom Typ "Korrekturfaktor" angewendet, falls einer vorhanden ist.
- Auf den ggf. korrigierten Wert wird als nächstes der passende Korrekturfaktor vom Typ "Nachweisgrenze" angewendet, falls einer vorhanden ist.
- Falls kein passender Korrekturfaktor vom Typ "Nachweisgrenze" vorhanden ist, wird auf den ggf. korrigierten Wert der passende Korrekturfaktor vom Typ "Bestimmungsgrenze" angewendet, falls einer vorhanden ist.
Als Anzeigewert wird der Anzeigewert des zuletzt angewendeten Korrekturfaktors verwendet, falls gesetzt.
Beispiel für Nachweis- und Bestimmungsgrenze
Ein häufiges einfaches Beispiel für die Pflege und Anwendung von Korrekturfaktoren für Nachweis- und Bestimmungsgrenze:
|
Typ |
Von (>=) |
Bis (<) |
Anzeigewert |
Multiplikator |
Offset |
|---|---|---|---|---|---|
|
Nachweisgrenze |
0,5 |
n.n. |
0 |
0,5 | |
|
Bestimmungsgrenze |
0,5 |
1 |
< 1 |
1 |
0 |
In jedem der drei Fälle wird die Bestimmungsgrenze '1' im Feld "Bestimmungsgrenze" am Probenergebnis gespeichert.
Optionen
KorrekturfaktorPriority
Prioritäten für die Auswahl der Korrekturfaktoren
- Typ der Option:
Felder zum Eintragen der Prioritäten - Pfad zur Option:
Module`Proben`Korrekturfaktoren``Prioritäten - Standardwert: „Produkt: 1; Produktgruppe: 2; Ansprechpartner: 3; Kunde: 4“
Mit dieser Option lässt sich einstellen, nach welcher Priorität Korrekturfaktoren greifen.
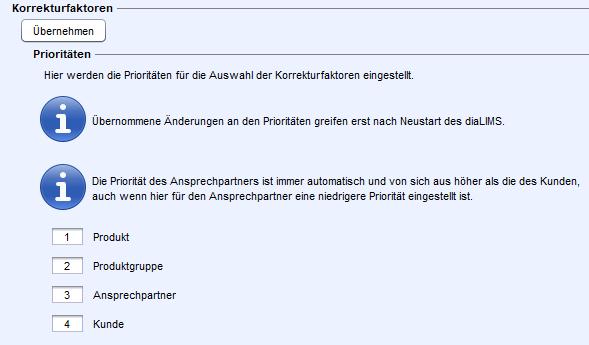
Die in den Optionen eingetragene Rangfolge gilt für alle Typen von Korrekturfaktoren (Korrekturfaktor/Nachweisgrenze/Bestimmungsgrenze).
Es muss für jeden Stammdatentyp eine Priorität (mindestens 1, höchstens 4) eingetragen sein. Doppelte Prioritäten sind nicht zugelassen.
Beispiel
Beispiel anhand des Standardwertes (Produkt: 1; Produktgruppe: 2; Ansprechpartner: 3; Kunde: 4):
- Ein Korrekturfaktor mit demselben Produkt wie die Probe wird bevorzugt genommen
- ein Korrekturfaktor mit derselben Produktgruppe wird als nächstes genommen
- ein Korrekturfaktor mit demselben Ansprechpartner wird als nächstes genommen
- ein Korrekturfaktor mit demselben Kunden (und ohne Ansprechpartner) wird als nächstes genommen
- als letztes wird ein Korrekturfaktor ohne Referenzen genommen
Anmerkung:
Die Priorität des Ansprechpartners ist immer automatisch und von sich aus höher als die des Kunden, auch wenn hier für den Ansprechpartner eine niedrigere Priorität eingestellt ist.